

- 시각적 이해: Qwen2.5-VL 파운데이션 모델을 통해 이미지 콘텐츠를 읽고 분석
- 텍스트 기반 이미지 생성: 텍스트 프롬프트로 고화질 이미지 생성
- 지시어 기반 이미지 편집: 자연어 지시로 복잡한 수정 수행
- 맥락 기반 생성: 여러 입력 이미지의 인물, 참조 객체, 장면을 조합해 새 이미지 생성
- 이중 경로 아키텍처: 3B Qwen2.5-VL 텍스트 모델과 독립적인 4B 확산 트랜스포머
- Omni-RoPE 위치 인코딩: 다중 이미지 공간 위치 지정 및 개체 식별 지원
- 파라미터 분리: 텍스트 자기회귀 생성이 이미지 품질에 영향을 주지 않도록 설계
- 이미지 내 텍스트: 생성된 이미지 안에 선명한 텍스트 표현 가능
OmniGen2 모델 다운로드
본 문서에는 다양한 워크플로우가 포함되어 있으므로, 해당 모델 파일과 설치 위치는 다음과 같습니다. 모델 파일의 다운로드 정보는 각 워크플로우에도 포함되어 있습니다. 확산 모델 VAE 텍스트 인코더 파일 저장 위치:ComfyUI OmniGen2 텍스트 기반 이미지 생성 워크플로우
OmniGen2: 텍스트 기반 이미지 생성
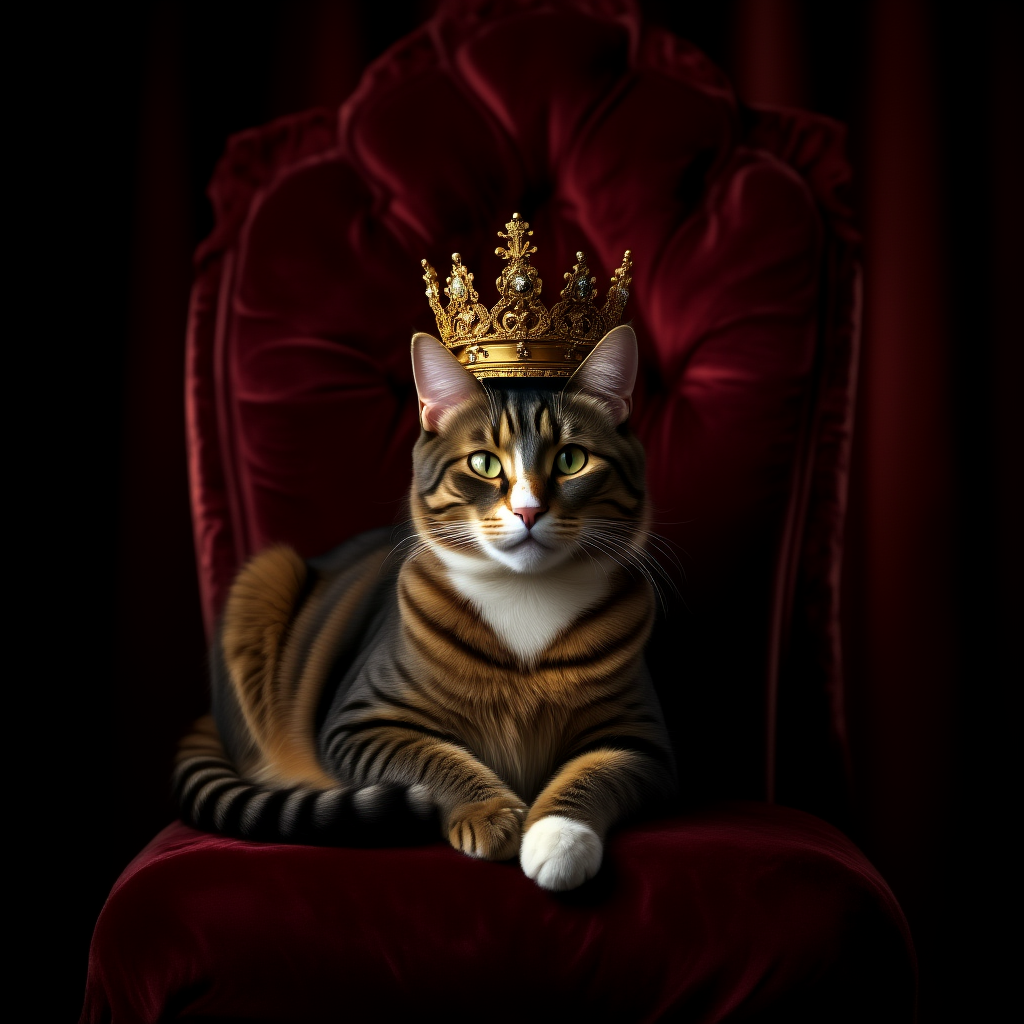
이중 경로 아키텍처를 갖춘 OmniGen2의 통합 7B 멀티모달 모델을 사용하여 텍스트 프롬프트에서 고품질 이미지를 생성하세요.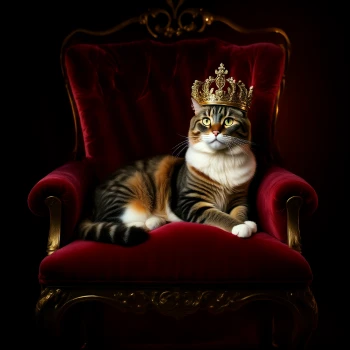
Comfy Cloud에서 실행
Comfy Cloud에서 이 워크플로우를 직접 열고 실행하세요.
워크플로우 다운로드
JSON을 다운로드하거나 템플릿 라이브러리에서 “OmniGen2”를 검색하세요.
1. 워크플로우 파일 다운로드
2. 워크플로우 단계별 완료
- 메인 모델 로드:
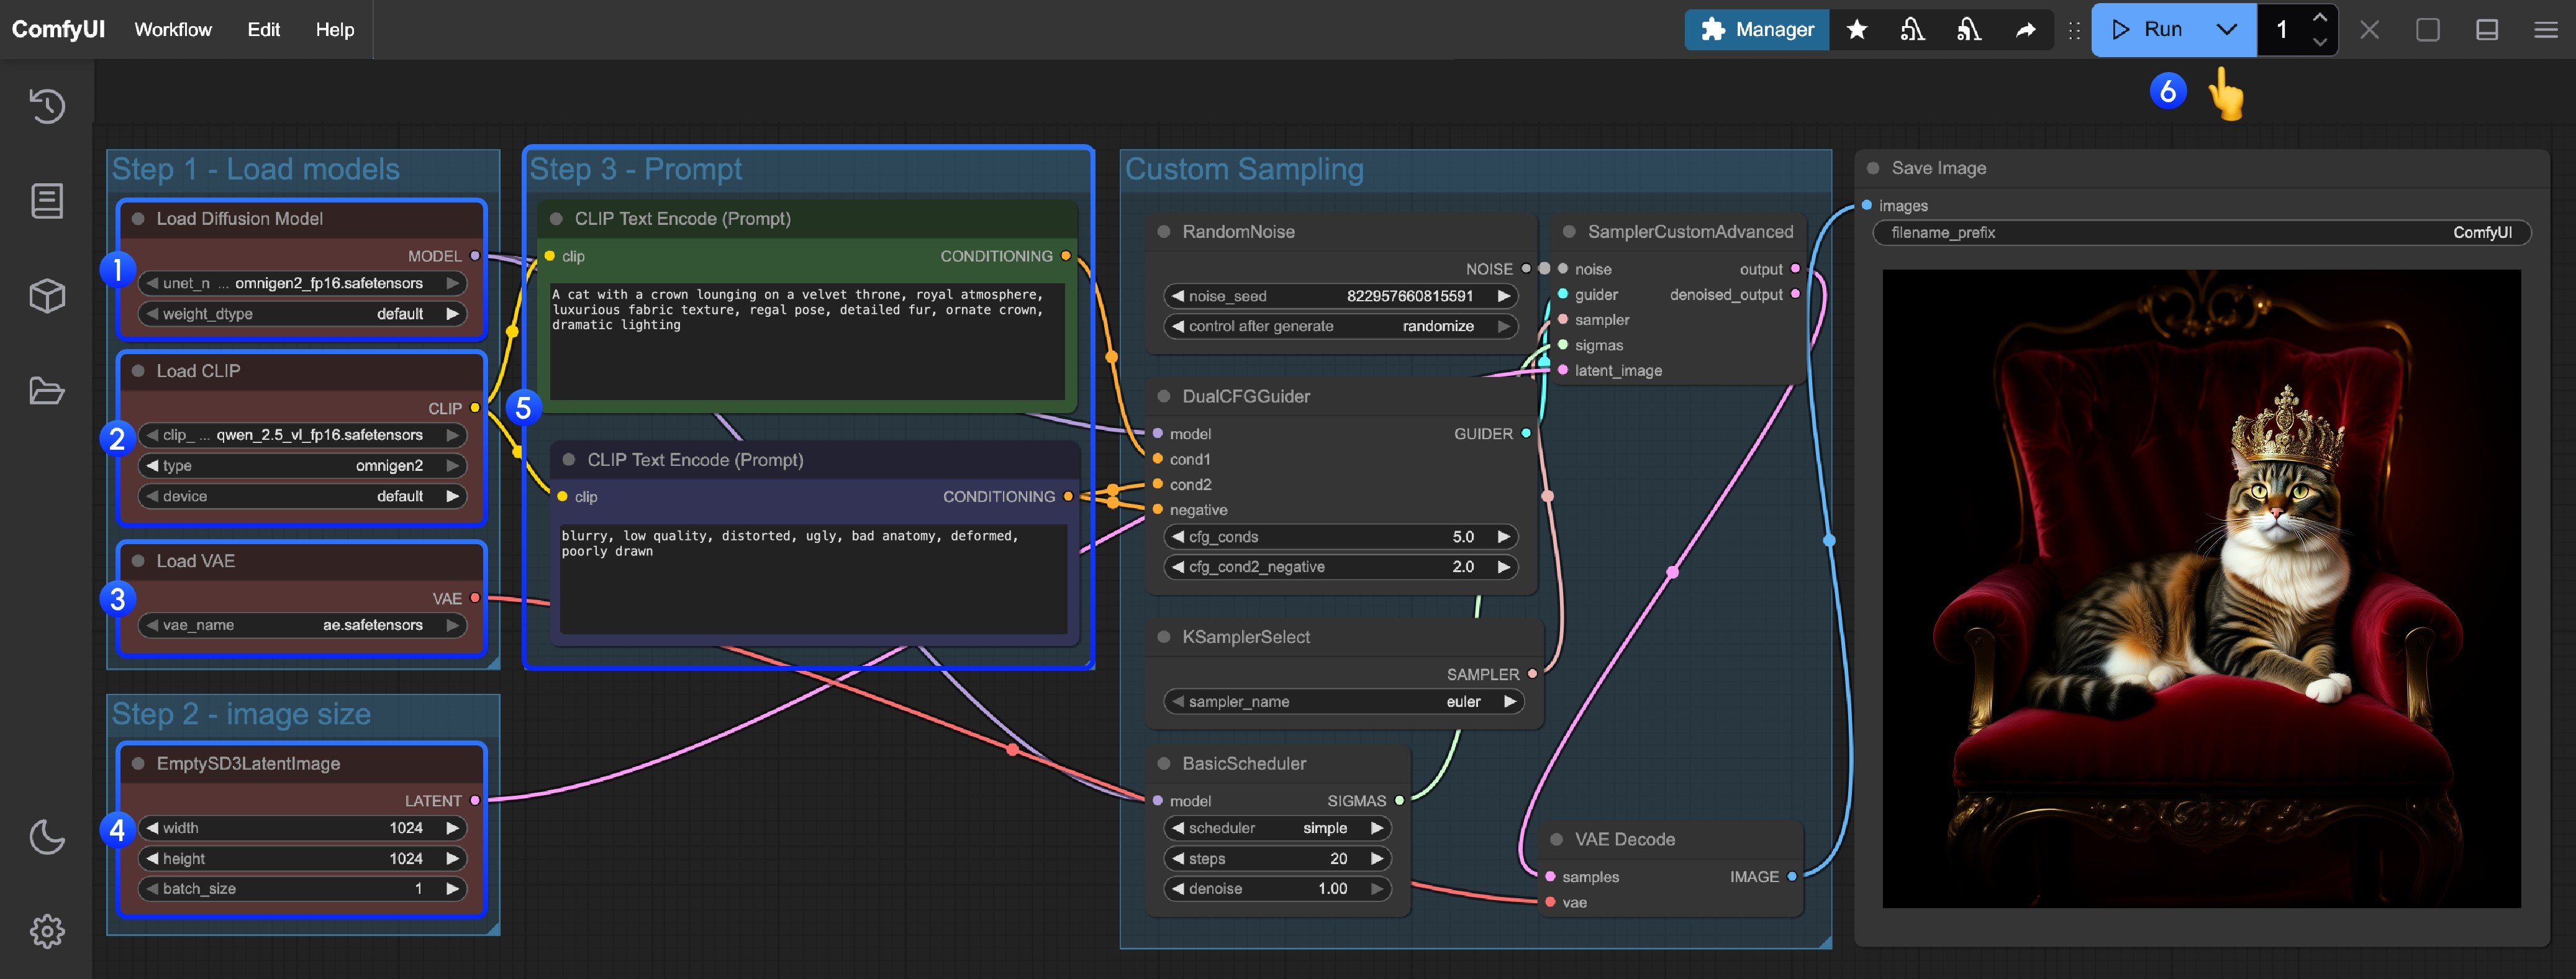
Load Diffusion Model노드가omnigen2_fp16.safetensors를 로드하는지 확인하세요. - 텍스트 인코더 로드:
Load CLIP노드가qwen_2.5_vl_fp16.safetensors를 로드하는지 확인하세요. - VAE 로드:
Load VAE노드가ae.safetensors를 로드하는지 확인하세요. - 이미지 크기 설정:
EmptySD3LatentImage노드에서 생성할 이미지 크기를 설정하세요(권장 크기 1024x1024). - 프롬프트 입력:
- 첫 번째
CLipTextEncode노드에 긍정적 프롬프트를 입력하세요(이미지에 나타나길 원하는 콘텐츠). - 두 번째
CLipTextEncode노드에 네거티브 프롬프트를 입력하세요(이미지에 나타나지 않길 원하는 콘텐츠).
- 첫 번째
- 생성 시작:
Queue Prompt버튼을 클릭하거나 단축키Ctrl(cmd) + Enter를 사용해 텍스트 기반 이미지 생성을 실행하세요. - 결과 확인: 생성이 완료된 후 해당 이미지가 자동으로
ComfyUI/output/디렉터리에 저장되며,SaveImage노드에서 미리보기할 수도 있습니다.
ComfyUI OmniGen2 이미지 편집 워크플로우
OmniGen2는 풍부한 이미지 편집 기능을 갖추고 있으며, 이미지에 텍스트 추가도 지원합니다.OmniGen2 이미지 편집
OmniGen2의 고급 이미지 편집 기능과 텍스트 렌더링 지원을 사용하여 자연어 지시로 이미지를 편집하세요.
Comfy Cloud에서 실행
이 워크플로우를 Comfy Cloud에서 직접 열고 실행하세요.
워크플로우 다운로드
JSON을 다운로드하거나 템플릿 라이브러리에서 “OmniGen2 Image Edit”을 검색하세요.
LoadImage 노드에 업로드하세요:
image_omnigen2_image_edit_input_image.png
LoadImage 노드 16 · image_omnigen2_image_edit_input_image.png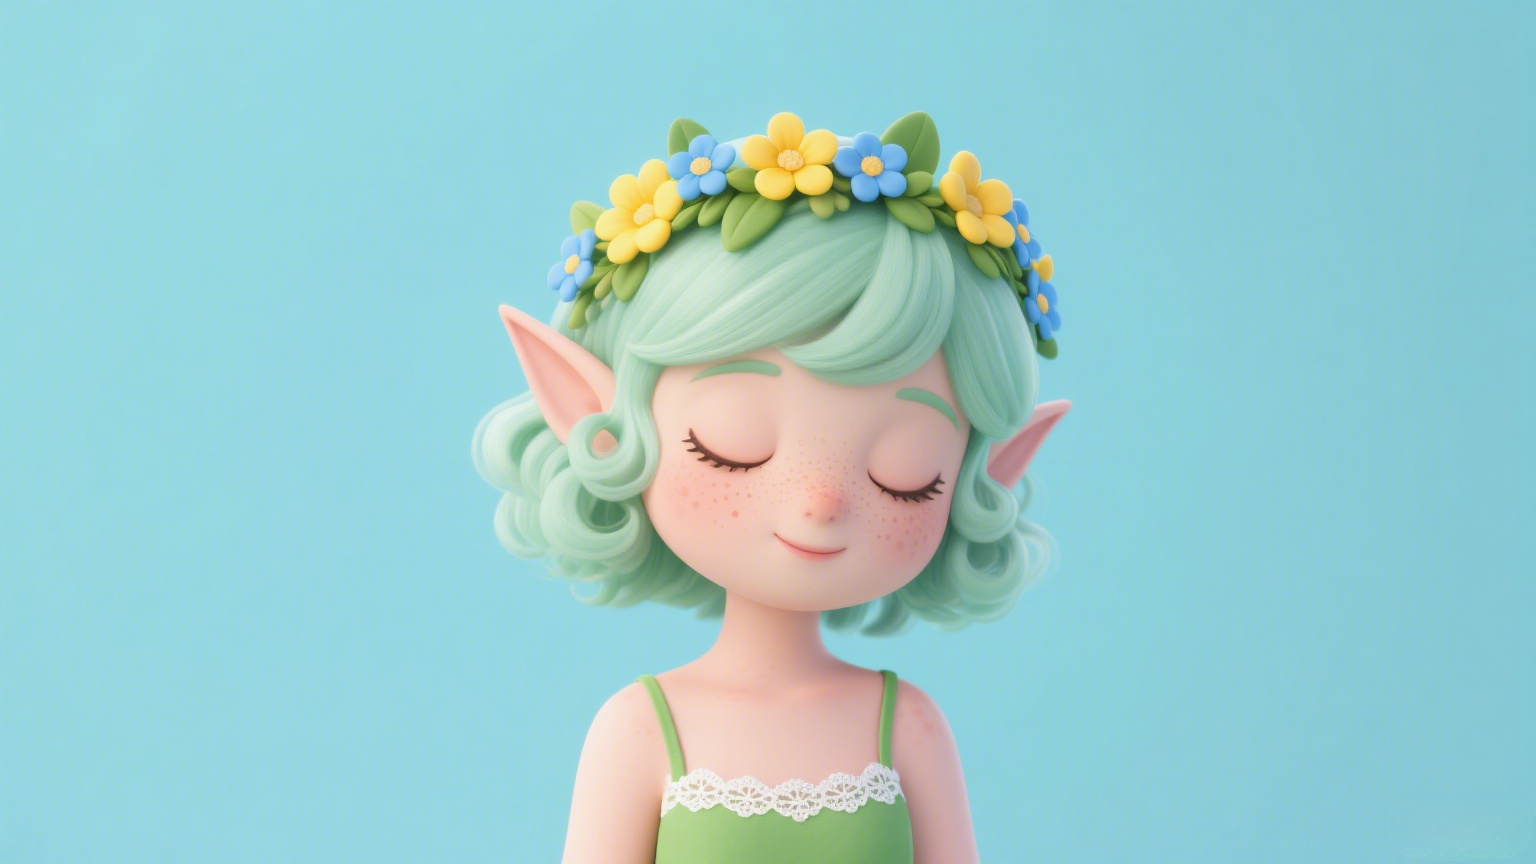
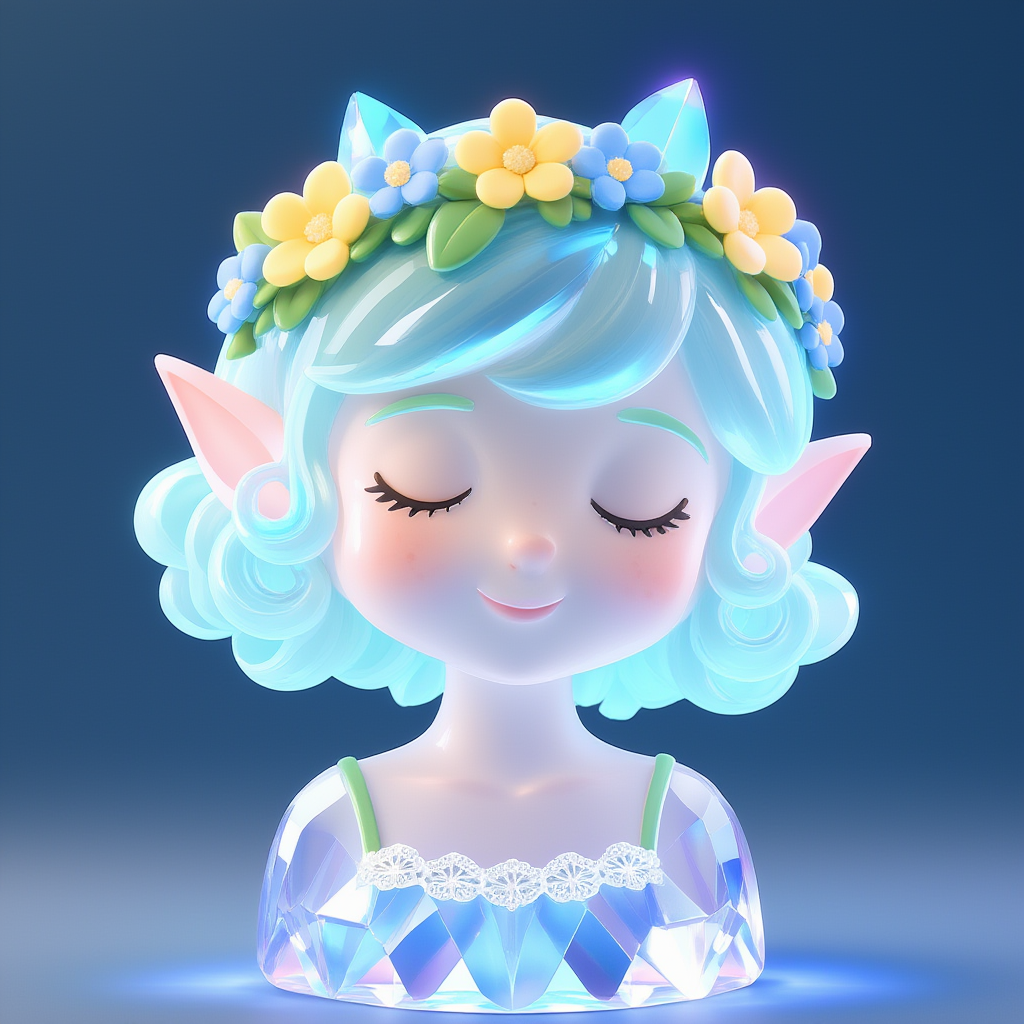
1. 워크플로우 파일 다운로드
2. 워크플로우 단계별 완료
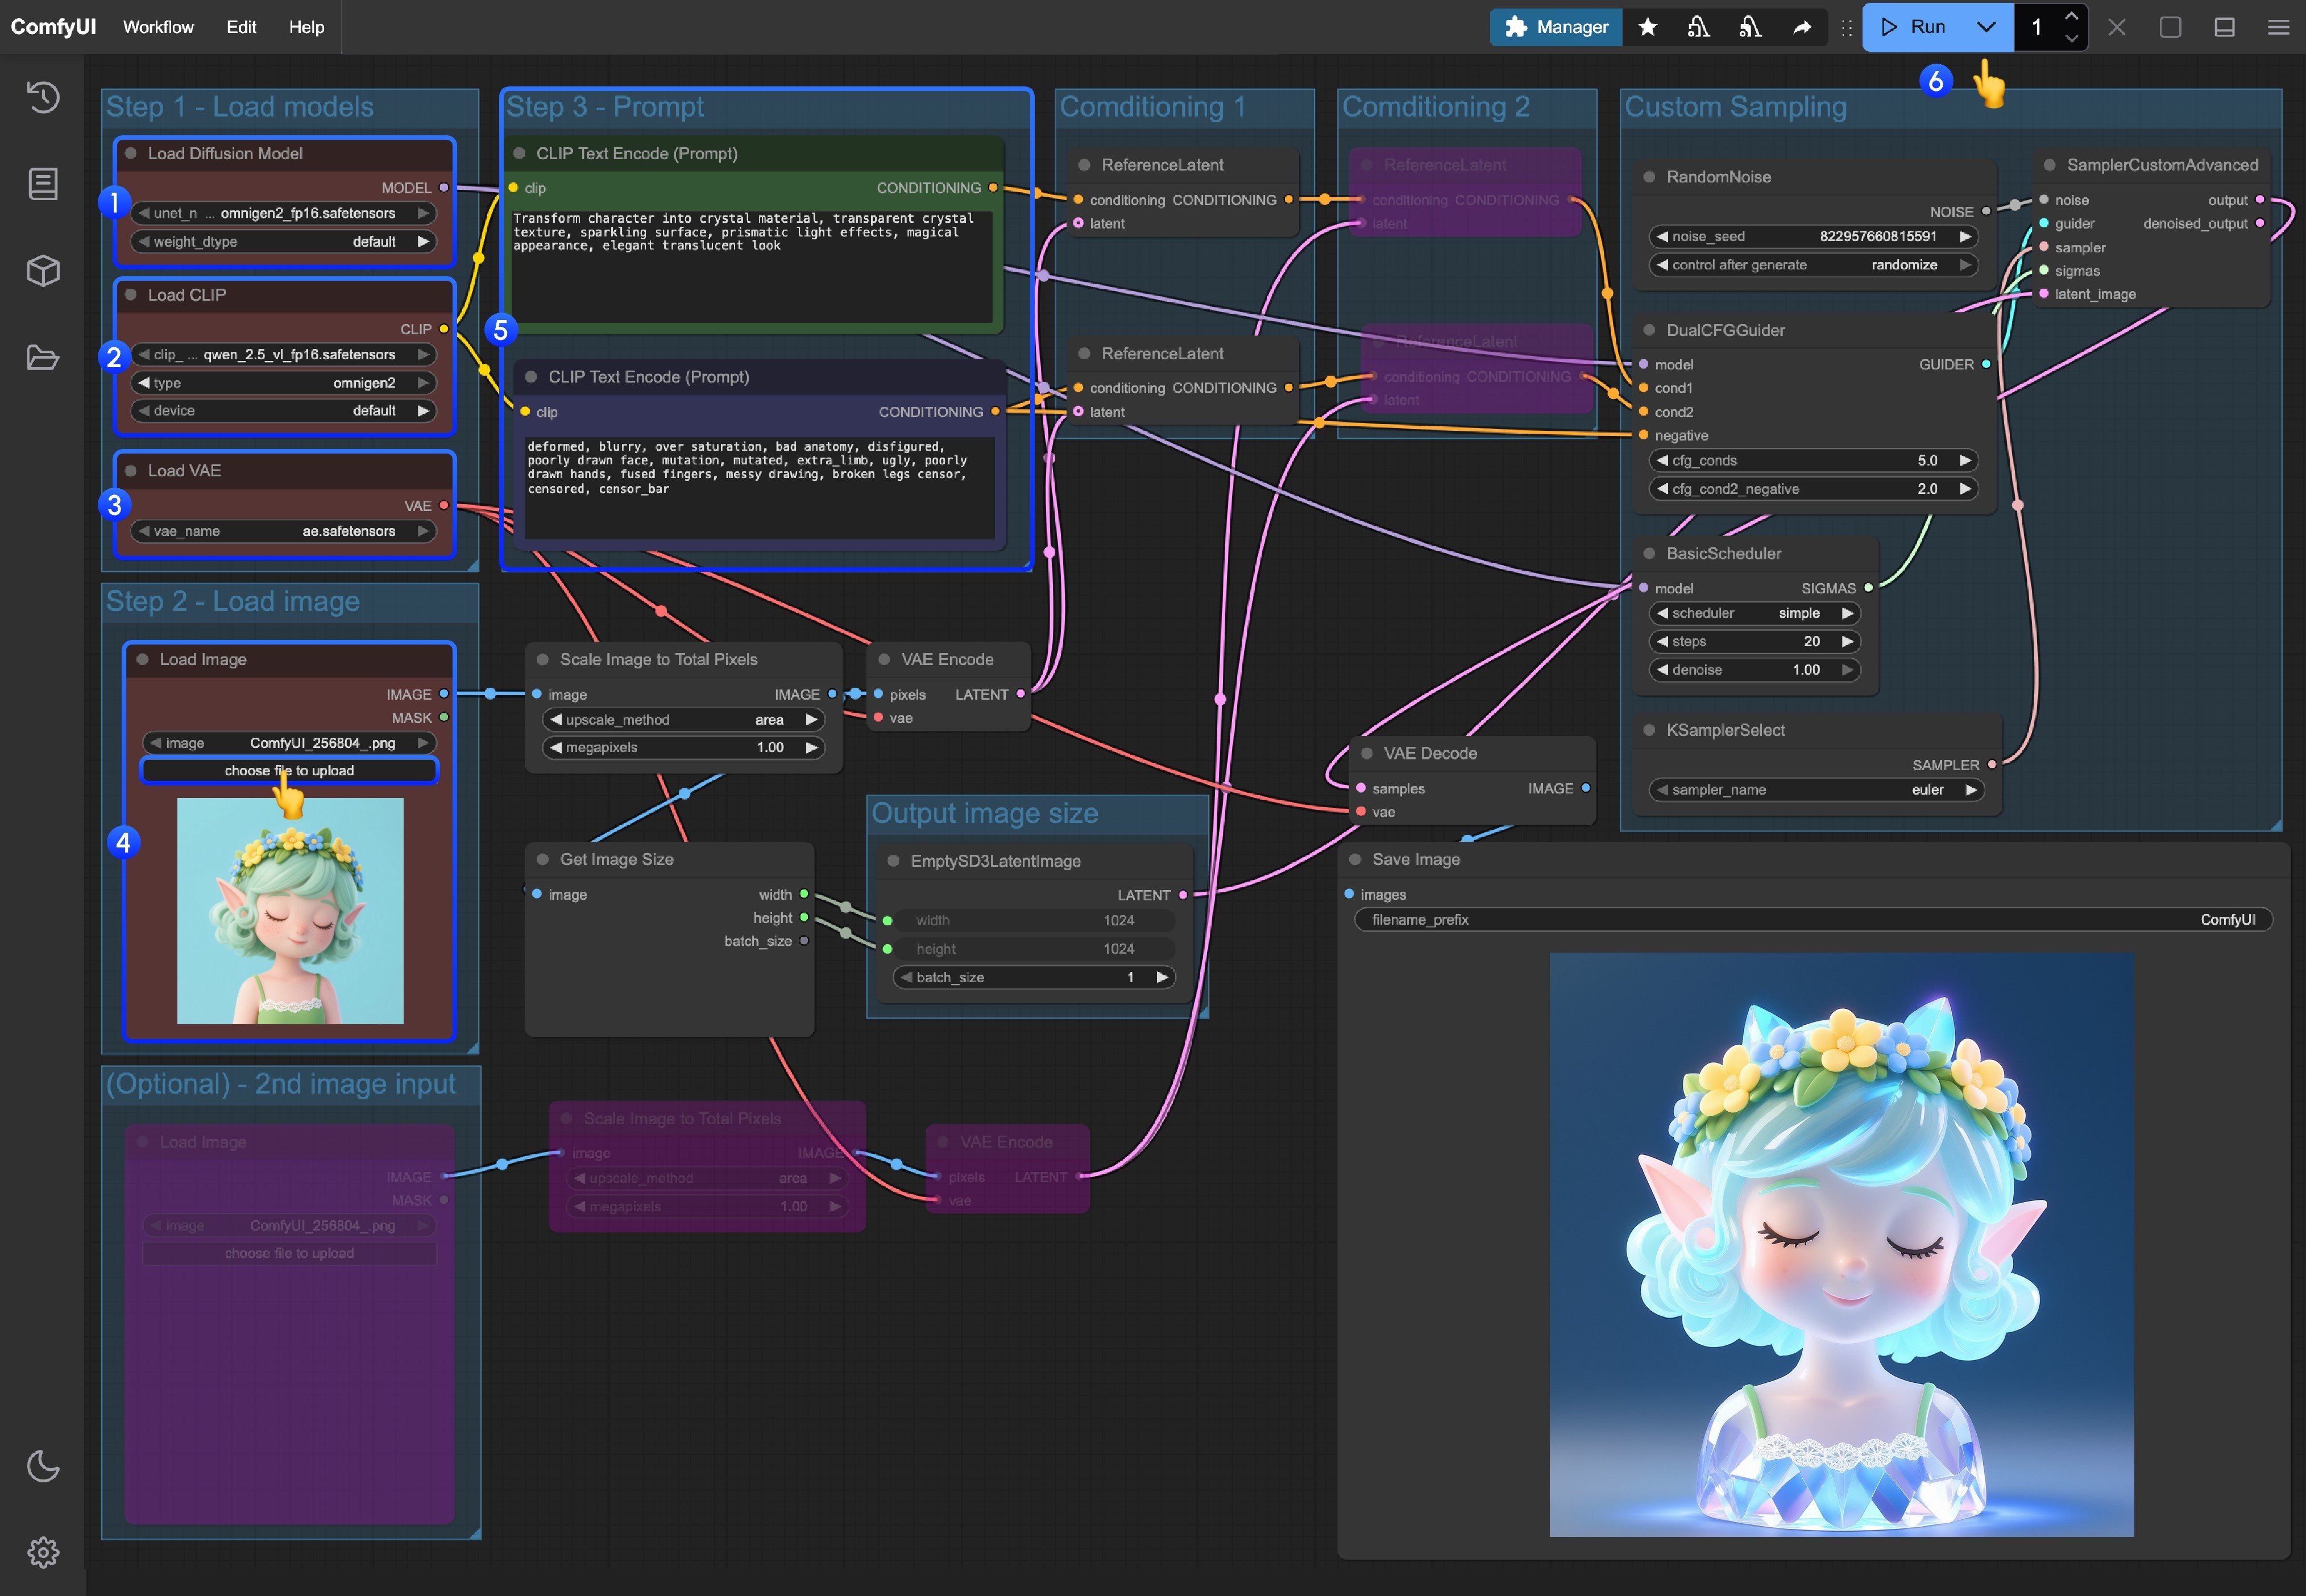
- 메인 모델 로드:
Load Diffusion Model노드가omnigen2_fp16.safetensors를 로드하는지 확인하세요. - 텍스트 인코더 로드:
Load CLIP노드가qwen_2.5_vl_fp16.safetensors를 로드하는지 확인하세요. - VAE 로드:
Load VAE노드가ae.safetensors를 로드하는지 확인하세요. - 이미지 업로드: 제공된 이미지를
Load Image노드에서 업로드하세요. - 입력 프롬프트:
- 첫 번째
CLipTextEncode노드에 긍정적 프롬프트를 입력하세요(이미지에 나타나길 원하는 내용). - 두 번째
CLipTextEncode노드에 부정적 프롬프트를 입력하세요(이미지에 나타나지 않길 원하는 내용).
- 첫 번째
- 생성 시작:
Queue Prompt버튼을 클릭하거나, 단축키Ctrl(cmd) + Enter를 사용해 텍스트 기반 이미지 생성을 실행하세요. - 결과 확인: 생성이 완료되면 해당 이미지들이 자동으로
ComfyUI/output/디렉터리에 저장되며,SaveImage노드에서 미리보기할 수 있습니다.
3. 추가 워크플로우 안내
- 두 번째 이미지 입력을 활성화하려면, 단축키 Ctrl + B를 사용하여 워크플로우에서 분홍색/보라색 상태인 노드의 해당 입력을 활성화할 수 있습니다.
- 크기를 사용자 정의하려면
EmptySD3LatentImage노드에 연결된Get image size노드를 삭제하고 사용자 정의 크기를 입력할 수 있습니다.