

- 視覚的理解: Qwen2.5-VL ベースモデルを通じて画像内容を読み取り・分析
- テキストから画像への生成: テキストプロンプトから高忠実度の画像を生成
- 指示に基づく画像編集: 自然言語の指示で複雑な編集を実行
- コンテキスト生成: 複数の入力画像から人物・参照オブジェクト・シーンを組み合わせて新しい画像を生成
- デュアルパスアーキテクチャ: 3B の Qwen2.5-VL テキストモデルと独立した 4B の拡散 Transformer
- Omni-RoPE 位置エンコーディング: 複数画像の空間的な位置付けと識別をサポート
- パラメータ分離: テキストの自己回帰生成が画像品質に影響しない設計
- 画像内テキスト: 生成画像内に明瞭なテキストを描画可能
OmniGen2 モデルのダウンロード
本記事では複数のワークフローを取り扱うため、対応するモデルファイルおよびインストール先は以下の通りです。各ワークフロー内にも、該当するモデルファイルのダウンロード情報が記載されています。 拡散モデル(Diffusion Models) VAE テキストエンコーダー(Text Encoders) ファイル保存先:ComfyUI OmniGen2 テキストから画像へ(Text-to-Image)ワークフロー
OmniGen2:テキストから画像へ
OmniGen2 の統合 7B マルチモーダルモデルとデュアルパスアーキテクチャを使用して、テキストプロンプトから高品質な画像を生成します。
Comfy Cloud で実行
Comfy Cloud でこのワークフローを直接開いて実行
ワークフローをダウンロード
JSON をダウンロードするか、テンプレートライブラリで “OmniGen2” を検索
1. ワークフローファイルのダウンロード
2. ワークフローの手順通り実行
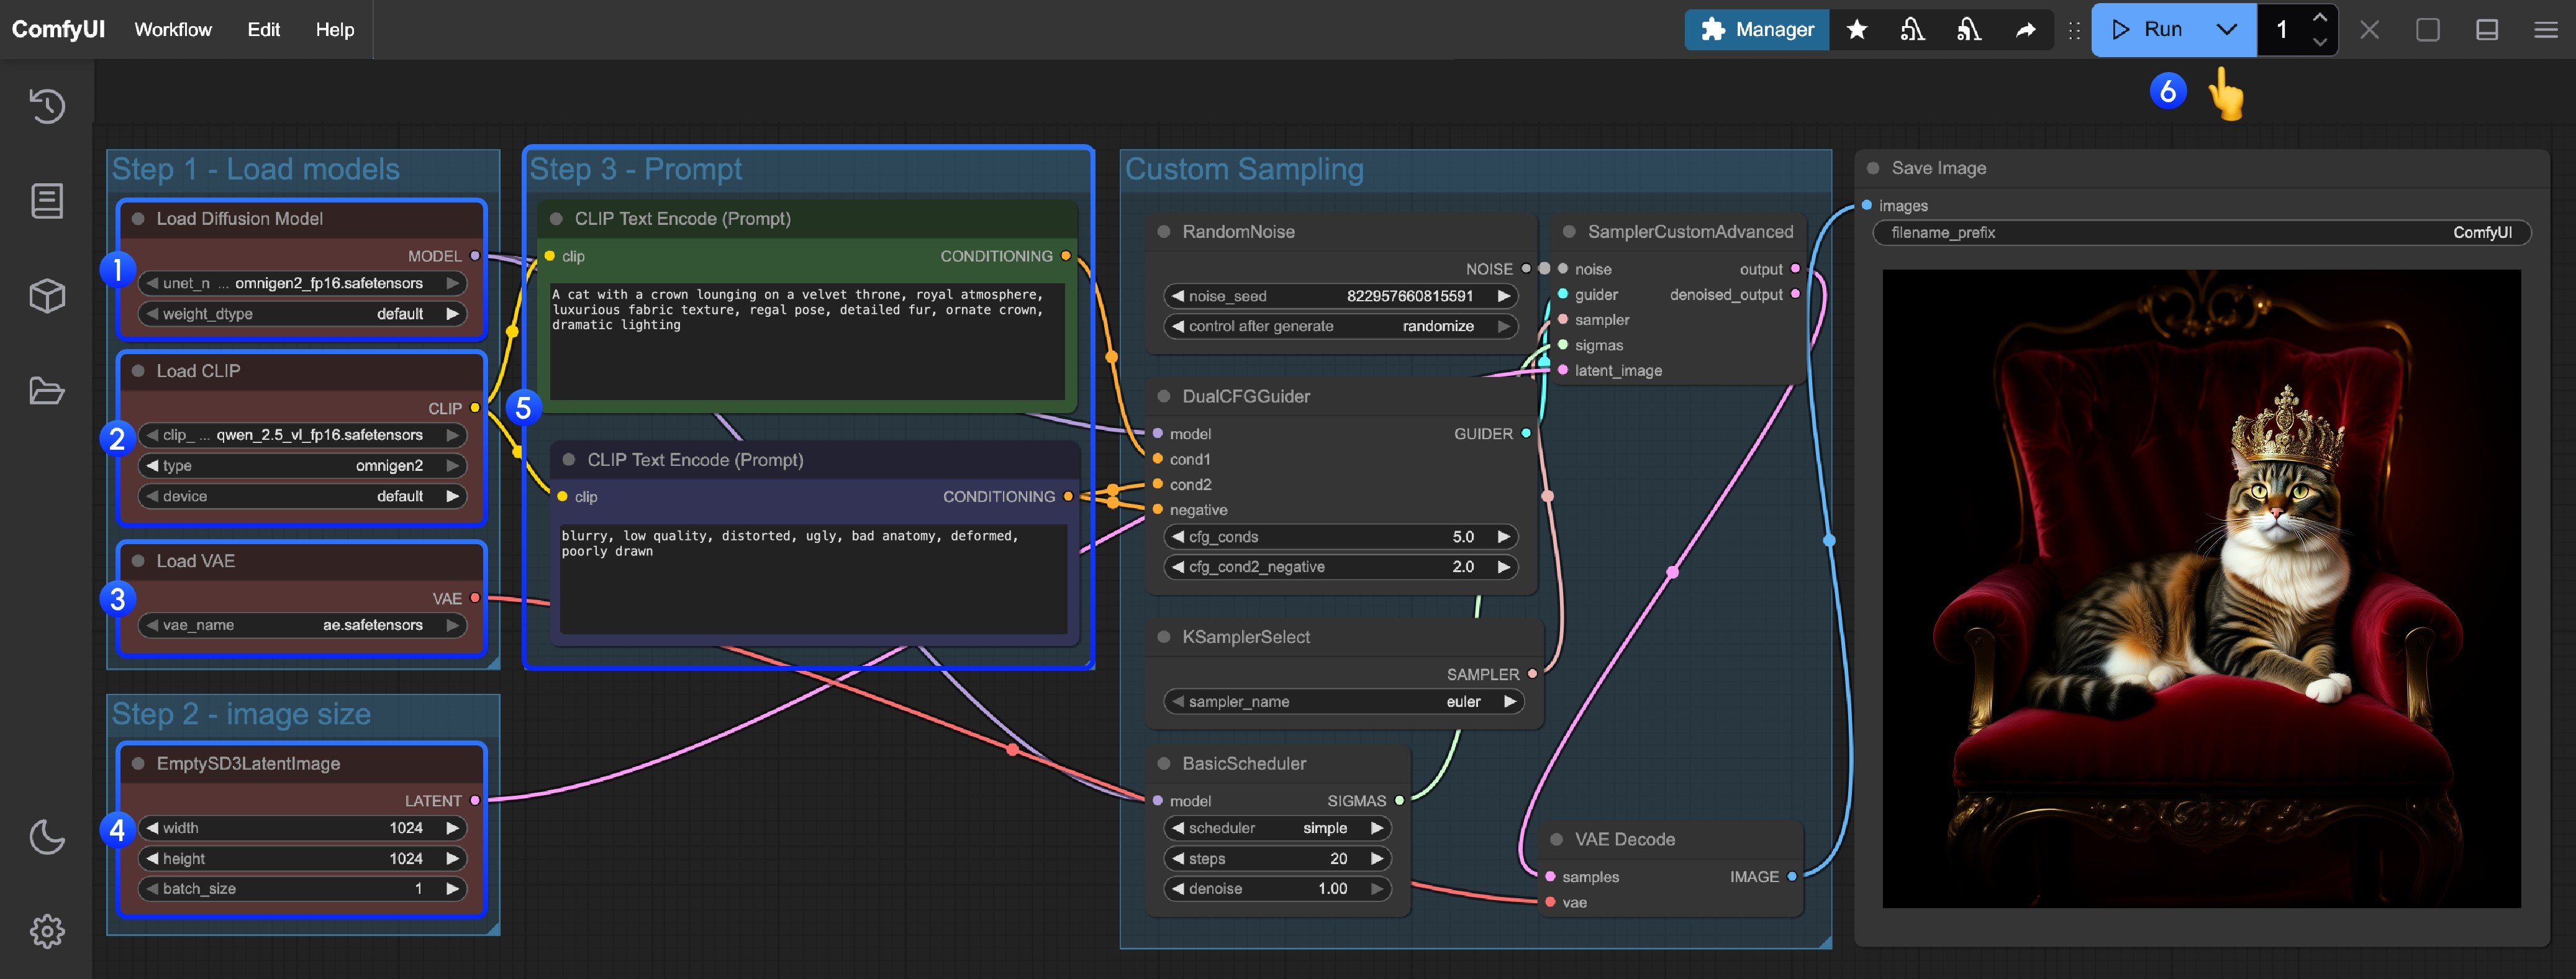
- メインモデルの読み込み:
Load Diffusion Modelノードがomnigen2_fp16.safetensorsを正しく読み込んでいることを確認 - テキストエンコーダーの読み込み:
Load CLIPノードがqwen_2.5_vl_fp16.safetensorsを正しく読み込んでいることを確認 - VAE の読み込み:
Load VAEノードがae.safetensorsを正しく読み込んでいることを確認 - 画像サイズの設定:
EmptySD3LatentImageノードで生成画像のサイズを設定(推奨:1024×1024) - プロンプトの入力:
- 最初の
CLipTextEncodeノードに「正のプロンプト」(画像に含めたい内容)を入力 - 2 つ目の
CLipTextEncodeノードに「負のプロンプト」(画像に含めたくない内容)を入力
- 最初の
- 生成開始:
Queue Promptボタンをクリックするか、ショートカットキーCtrl(Mac の場合は Cmd)+ Enterを押してテキストから画像への生成を実行 - 結果の確認: 生成が完了すると、対応する画像が自動的に
ComfyUI/output/ディレクトリに保存されます。また、SaveImageノード内でプレビューも可能です
ComfyUI OmniGen2 画像編集ワークフロー
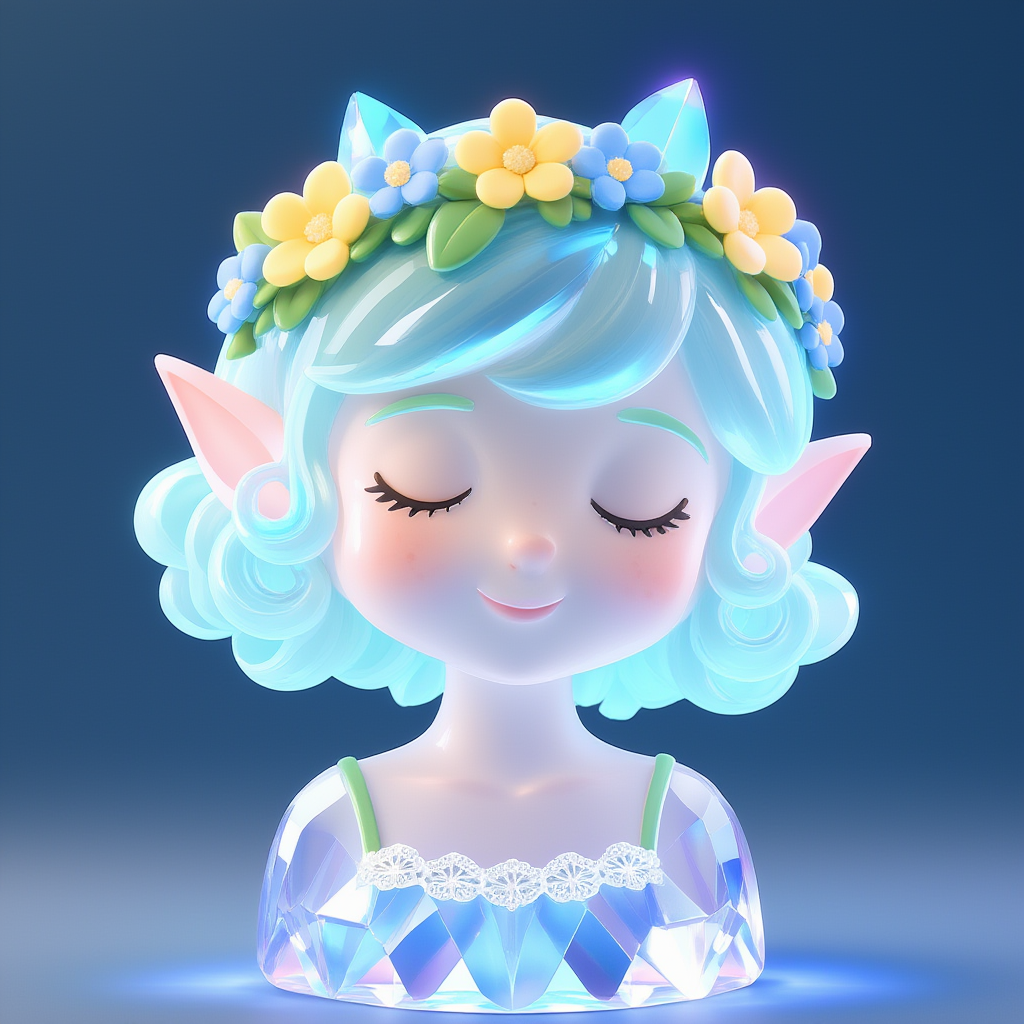
OmniGen2 は豊富な画像編集機能を備えており、画像へのテキスト追加もサポートします。OmniGen2 画像編集
OmniGen2 の高度な画像編集機能とテキストレンダリング対応により、自然言語の指示で画像を編集できます。
Comfy Cloud で実行
このワークフローを Comfy Cloud で直接開いて実行できます
ワークフローをダウンロード
JSON をダウンロードするか、テンプレートライブラリで「OmniGen2 Image Edit」を検索
LoadImage ノードにアップロードしてください:
image_omnigen2_image_edit_input_image.png
LoadImage ノード 16 · image_omnigen2_image_edit_input_image.png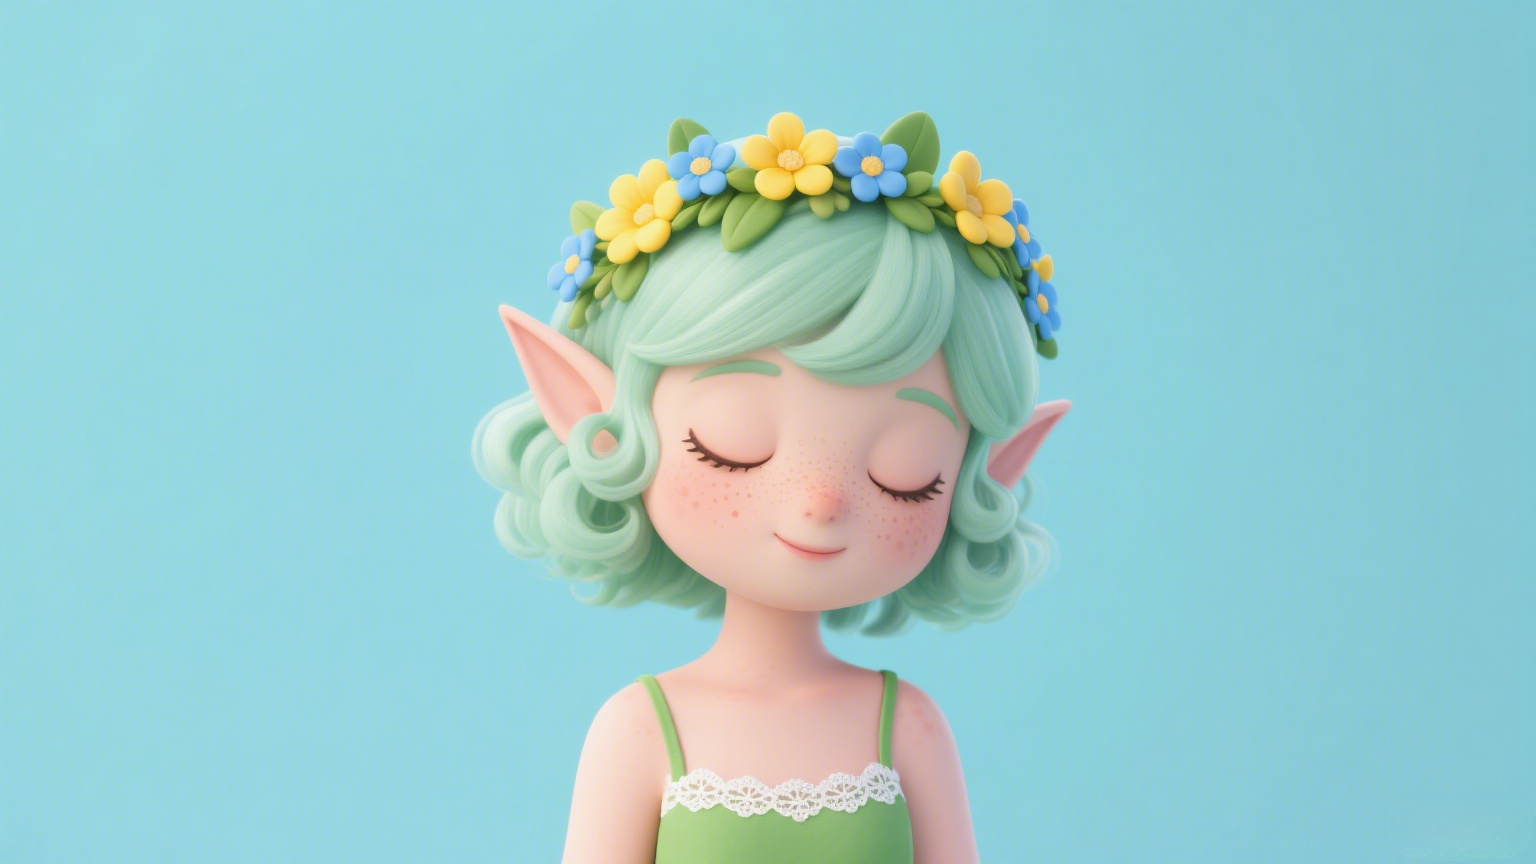
1. ワークフローファイルのダウンロード
2. ワークフローの手順通り実行
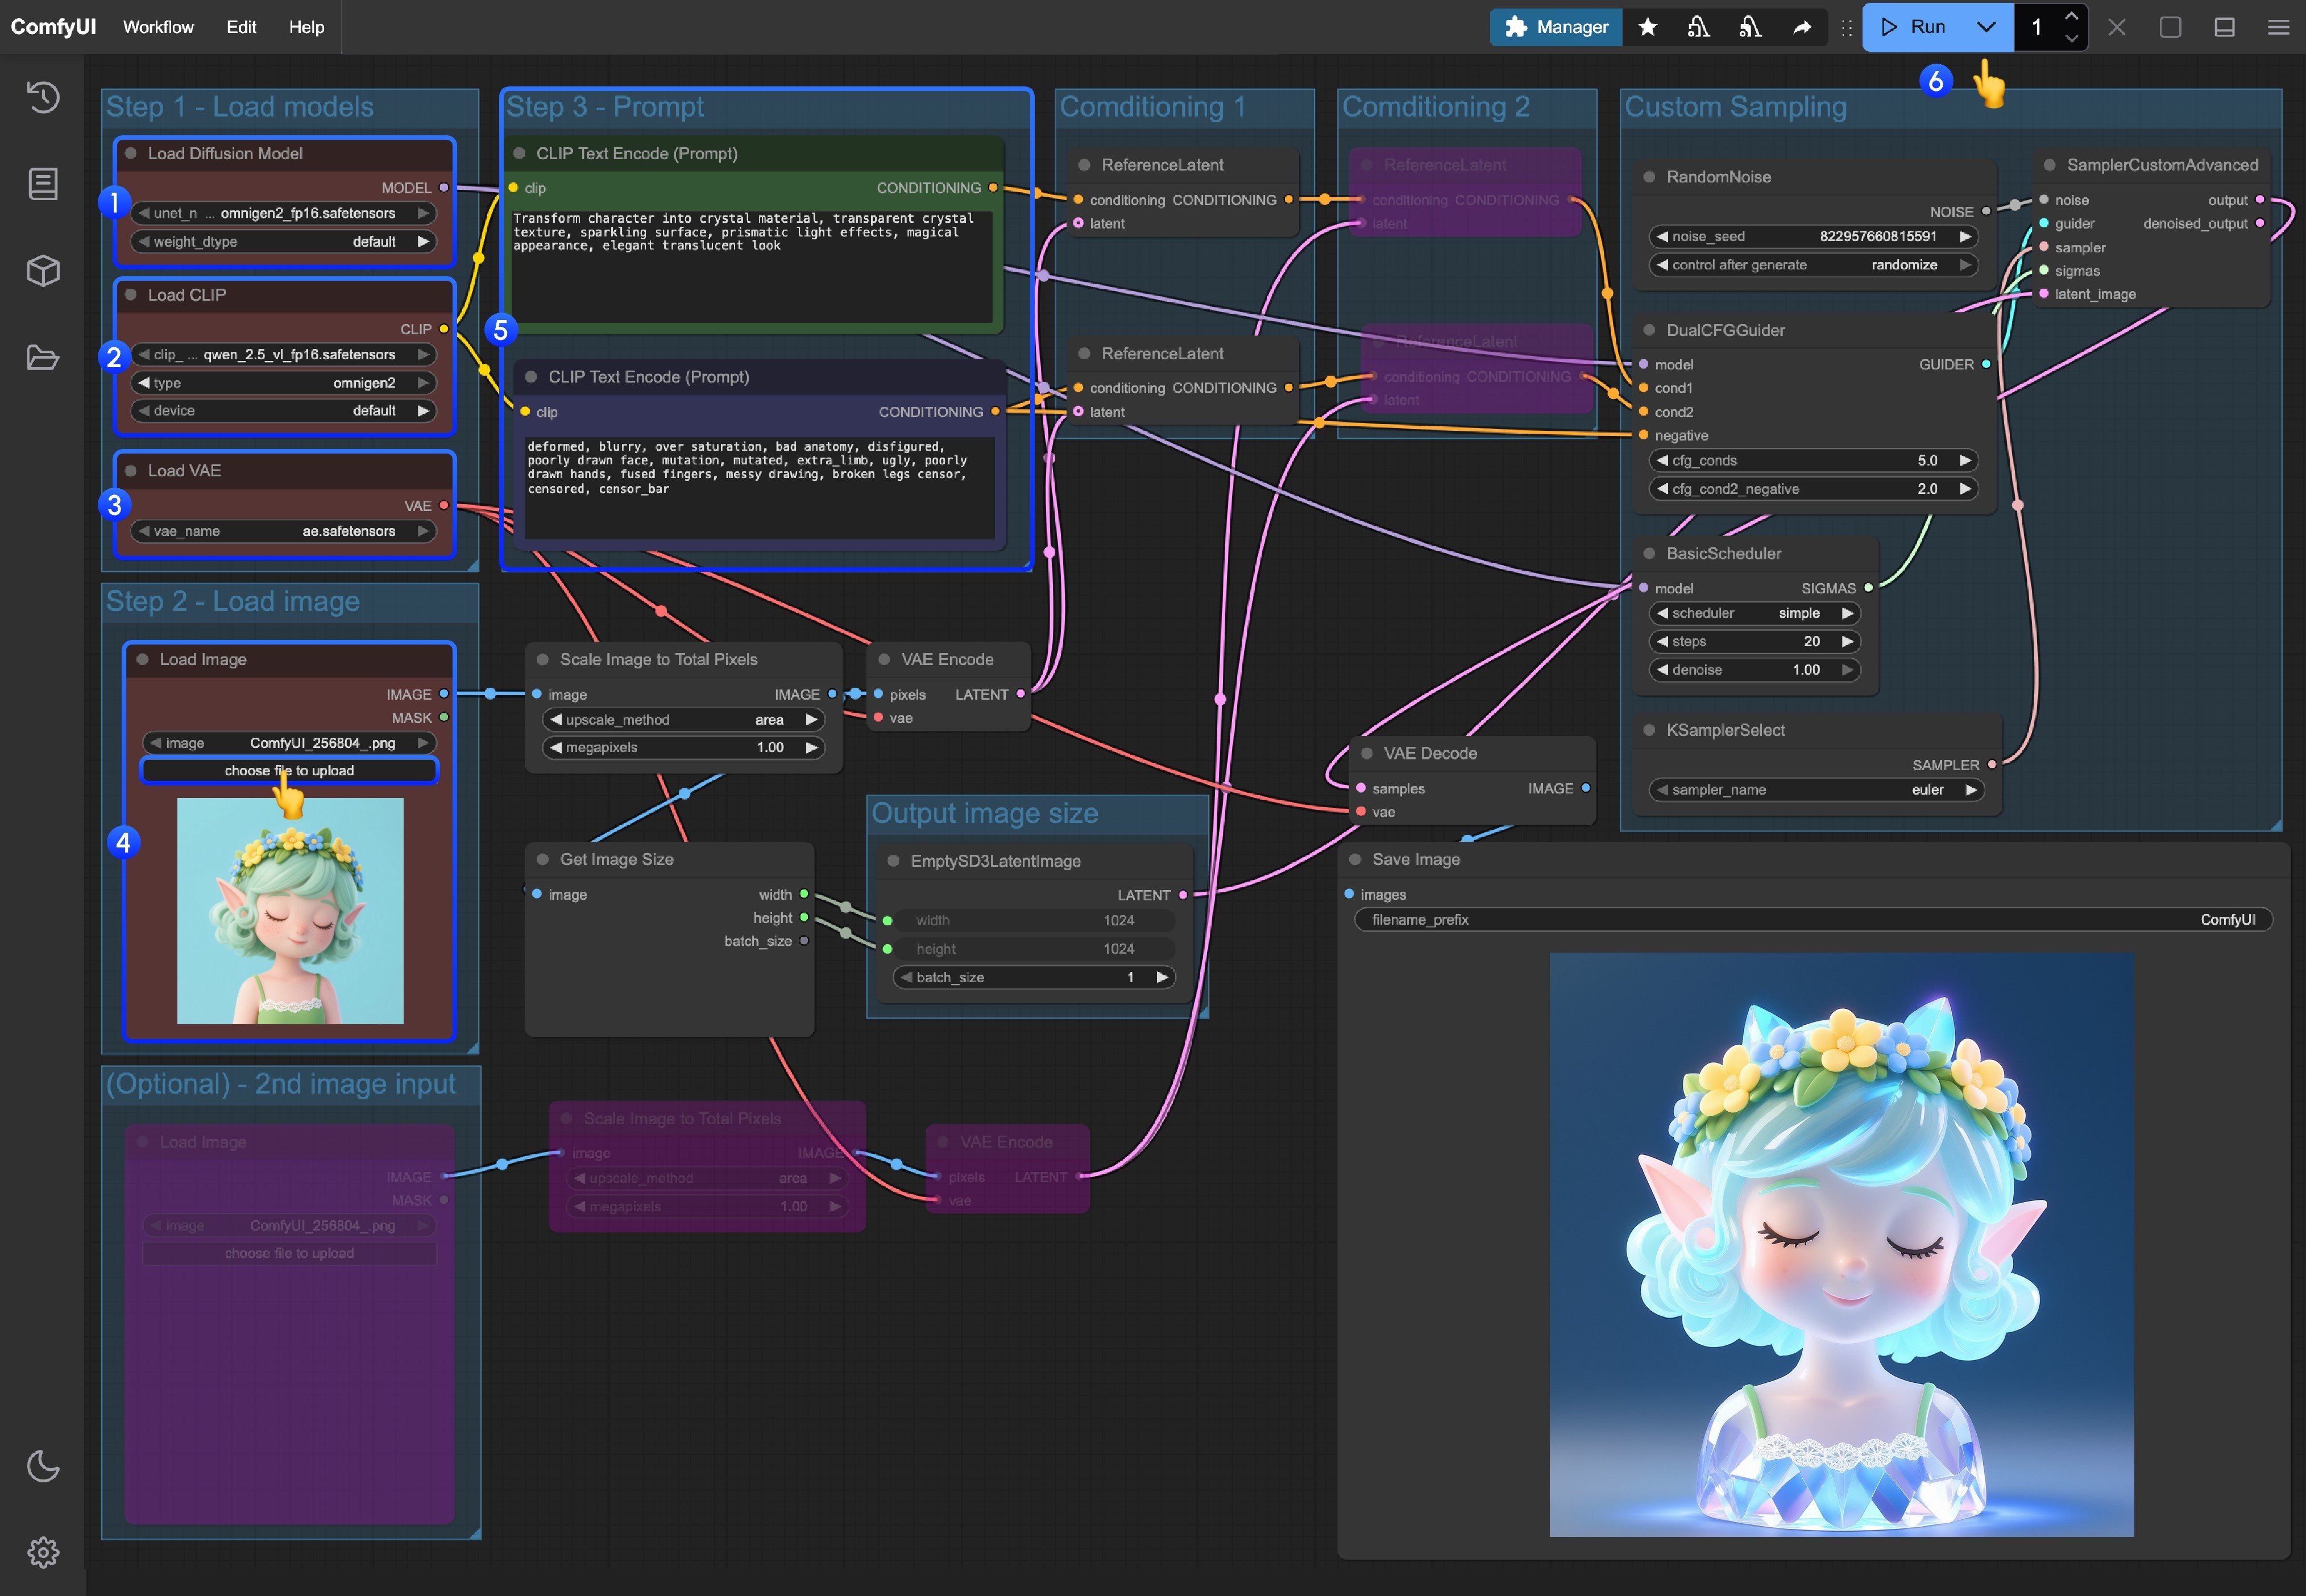
- メインモデルの読み込み:
Load Diffusion Modelノードがomnigen2_fp16.safetensorsを正しく読み込んでいることを確認 - テキストエンコーダーの読み込み:
Load CLIPノードがqwen_2.5_vl_fp16.safetensorsを正しく読み込んでいることを確認 - VAE の読み込み:
Load VAEノードがae.safetensorsを正しく読み込んでいることを確認 - 画像のアップロード:
Load Imageノードで上記の画像をアップロード - プロンプトの入力:
- 最初の
CLipTextEncodeノードに「正のプロンプト」(画像に含めたい内容)を入力 - 2 つ目の
CLipTextEncodeノードに「負のプロンプト」(画像に含めたくない内容)を入力
- 最初の
- 生成開始:
Queue Promptボタンをクリックするか、ショートカットキーCtrl(Mac の場合は Cmd)+ Enterを押して画像編集を実行 - 結果の確認: 生成が完了すると、対応する画像が自動的に
ComfyUI/output/ディレクトリに保存されます。また、SaveImageノード内でプレビューも可能です
3. 追加のワークフロー操作説明
- 第二の画像入力を有効化したい場合、ワークフロー内でピンク/パープル色で表示されているノードに対し、ショートカットキー Ctrl + B を使用して、対応する入力ポートを有効化できます
- カスタムサイズを指定したい場合、
EmptySD3LatentImageノードに接続されているGet image sizeノードを削除し、任意のサイズを直接入力してください